

Chi Le✔
Thành viên nổi tiếng
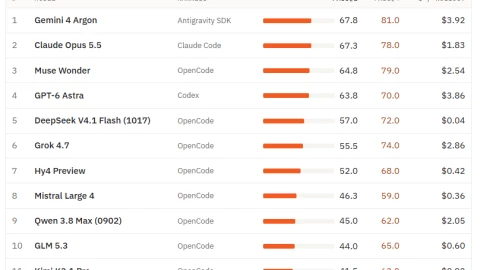
Việc đánh giá khả năng phòng thủ của các mô hình ngôn ngữ lớn đã trở nên minh bạch và gay gắt hơn bao giờ hết với sự xuất hiện của phiên bản mới trong bộ công cụ kiểm thử. CWE-bench v2 mang đến một quy mô đánh giá rộng lớn hơn với 100 tác vụ tập trung vào 91 loại lỗ hổng phần mềm khác nhau, yêu cầu các mô hình không chỉ nhận diện mẫu quen thuộc mà còn phải hiểu sâu sắc về các bề mặt tấn công tiềm ẩn. Theo bài đăng từ blog chuyên sâu của Hugging Face, mục tiêu cốt lõi của dự án này là đảm bảo sự toàn diện, đòi hỏi một mô hình AI phải phản ứng chính xác trong mọi tình huống giả định mà kẻ tấn công có thể khai thác. Mỗi nhiệm vụ trong bộ dữ liệu này đều được rà soát thủ công tỉ mỉ, nhấn mạnh cam kết về chất lượng và tính minh bạch tuyệt đối. Kết quả đo lường hiện tại cho thấy một sự cạnh tranh khốc liệt giữa các mô hình dẫn đầu trên thị trường công nghệ toàn cầu. Gemini 4 Argon...
Đọc bài gốc tại đây