 Đoạn Video
 Ảnh
Màu của em✔
Thành viên nổi tiếng
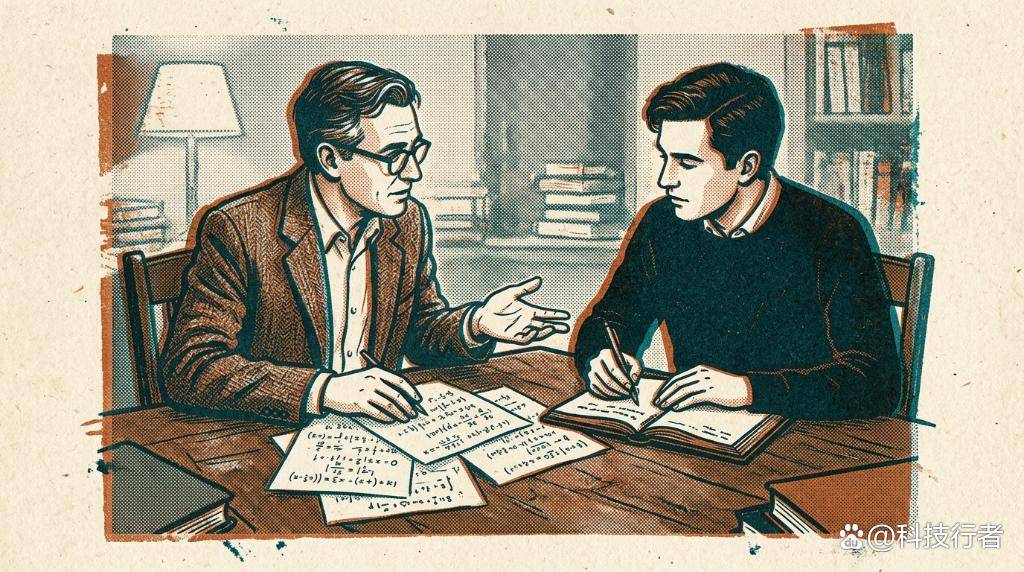
Nếu hỏi một kỹ sư AI làm về hậu huấn luyện mô hình lớn (LLM) vào tháng 8 năm 2024 rằng "chưng cất có đáng tin cậy không", có lẽ bạn sẽ nhận được câu trả lời là "có, hiệu quả ổn định, cả ngành đều dùng". Nhưng nếu hỏi thêm, "Bạn có chắc học sinh học được năng lực của giáo viên, chứ không chỉ ghi nhớ đáp án của vài bài tập huấn luyện không?", nhiều người sẽ phải suy nghĩ lại. Đây chính là điểm mù mà một bài báo khoa học mới đây đã chỉ ra. Trong vài năm qua, kỹ thuật "chưng cất chiến lược trực tuyến" (On-Policy Distillation - OPD) đã trở thành một phần không thể thiếu trong huấn luyện các mô hình ngôn ngữ lớn, xuất hiện trong báo cáo kỹ thuật của hầu hết các mô hình hàng đầu như Kimi hay DeepSeek. Tuy nhiên, một vấn đề chung của hầu hết các phương pháp đánh giá là chúng chỉ chấm điểm trong lĩnh vực, ngôn ngữ và độ khó của các câu hỏi được dùng để huấn luyện. Điều này giống như việc bạn dạy một học sinh làm toán, rồi...
Đọc bài gốc tại đây